MLOps · Systèmes distribués · 29 septembre 2026
Observabilité pour les services d’IA distribués
Méthode
Question de départ. Comment reconstruire l’histoire d’une prédiction quand le service est distribué ?
Une prédiction n’est pas un simple résultat : c’est un événement situé dans une chaîne de données, de code, de modèle et de service.
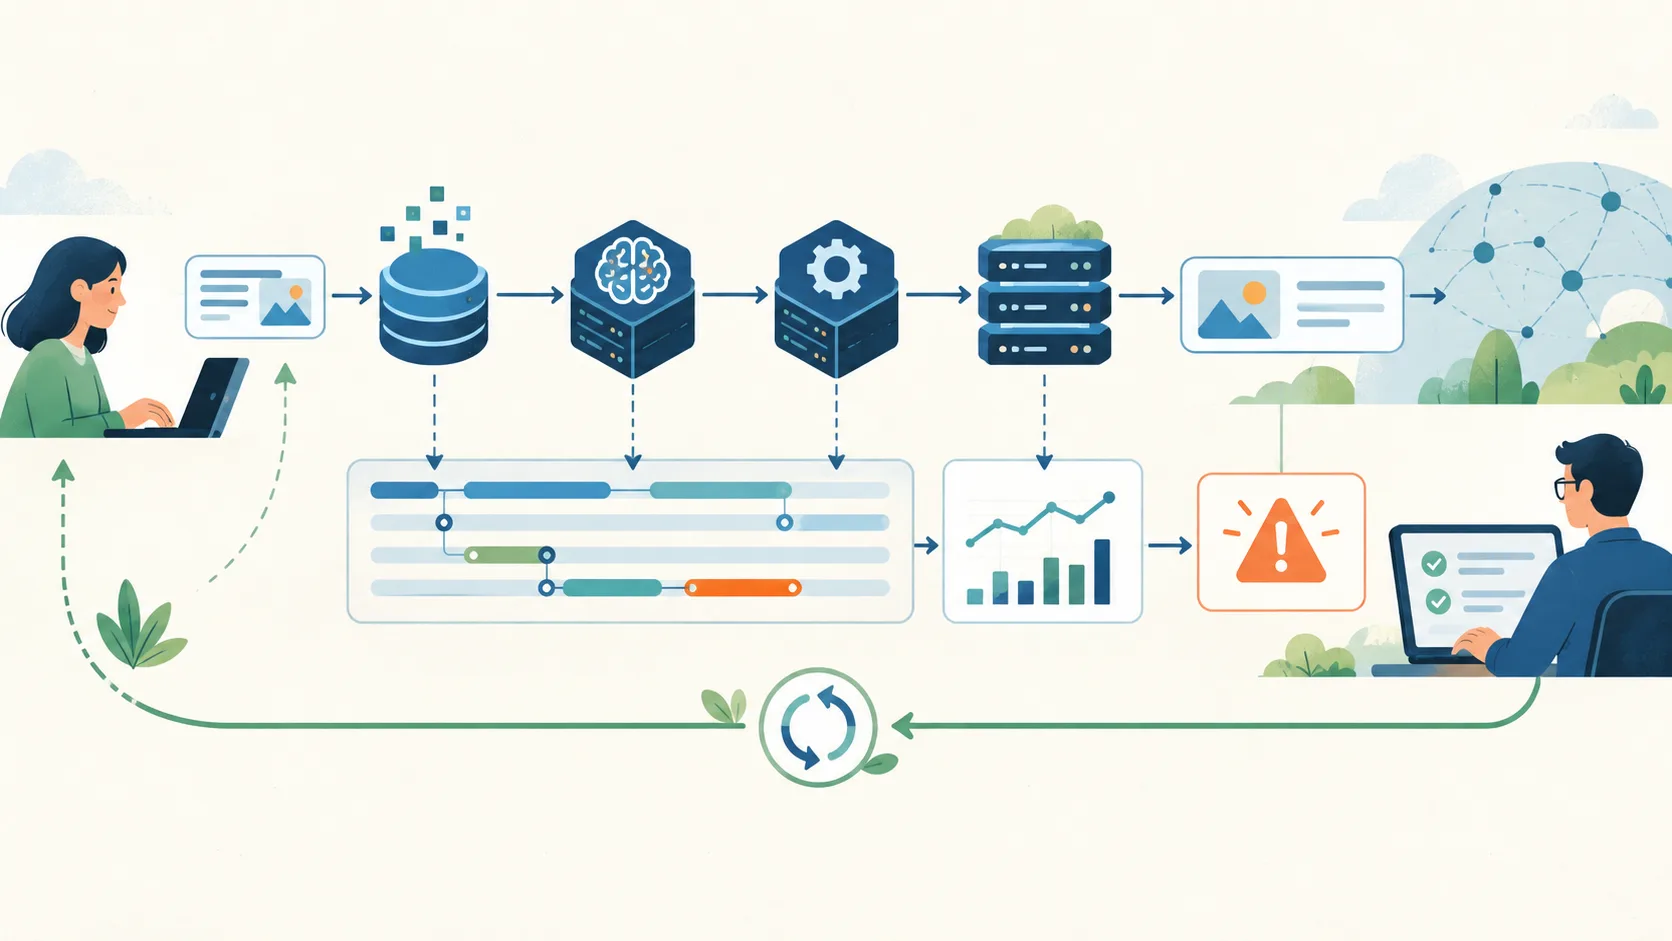
Un tableau de bord peut être vert alors qu’une partie des utilisateurs reçoit des réponses lentes ou incohérentes. Dans un service d’IA distribué, l’observability désigne la capacité à comprendre l’état interne d’un système à partir de ses signaux externes. Elle consiste ici à reconstruire l’histoire d’une prédiction : quelle requête est arrivée, quelles données ont été préparées, quelle version du modèle a répondu et quelle décision a suivi.
Les trois signaux classiques sont les traces — le parcours d’une requête —, les metrics — les mesures agrégées — et les logs — les événements détaillés. Une trace est généralement composée de plusieurs spans, par exemple un span pour l’API, un autre pour la récupération documentaire et un dernier pour l’appel au modèle.
Les technologies existantes et leur angle mort
OpenTelemetry fournit une base neutre pour instrumenter les traces, les métriques et les journaux. Prometheus et Grafana peuvent suivre les indicateurs d’infrastructure, tandis qu’un outil de suivi d’expériences ou de lignage relie un modèle à ses données, son code et ses artefacts. Pour les dérives, des bibliothèques de validation statistique peuvent comparer les distributions d’entrée et de sortie.
Ces briques répondent à « que s’est-il passé ? » mais pas toujours à « pourquoi cette décision était-elle acceptable ? ». La question de recherche est donc : comment associer une trace technique à une preuve métier et à un droit de recours, sans enregistrer plus de données personnelles que nécessaire ? La réponse doit tenir compte de la latence, du coût de stockage, de la confidentialité et de la capacité réelle d’une équipe à lire les traces.
Commencer par un identifiant de trace
Chaque requête devrait pouvoir être reliée à un correlation ID propagé entre l’API, le service de caractéristiques, le serveur de modèle et le système de journalisation. Sans cette clé, on observe des fragments : une latence côté API, une erreur côté modèle, mais aucune manière fiable de les relier.
Un événement de prédiction peut commencer avec un contrat minimal :
{
  "trace_id": "...",
  "model_version": "2026.09.1",
  "input_schema": "customer-v3",
  "latency_ms": 184,
  "outcome": "accepted",
  "confidence_band": "medium"
}
Les données sensibles ne doivent pas être copiées sans nécessité. L’objectif est de conserver les éléments permettant d’expliquer et de diagnostiquer, pas de constituer une seconde base de données personnelle.
Relier les bons signaux
| Signal | Question opérationnelle | Exemple d’action |
|---|---|---|
| Latence | Où le temps est-il consommé ? | Isoler le service ou la dépendance lente |
| Erreurs | Quelle étape échoue ? | Rejouer un cas avec le même trace ID |
| Distribution des entrées | Les usages ont-ils changé ? | Déclencher une analyse de drift |
| Sorties et abstentions | Le modèle répond-il avec assez de preuves ? | Limiter ou revoir la politique de décision |
| Version | Quel artefact est responsable ? | Comparer avec la version précédente |
Les agrégats sont utiles pour repérer une tendance, mais les échantillons d’erreurs restent nécessaires pour comprendre les cas rares, les refus et les changements de population. Il faut donc conserver un équilibre entre high-cardinality data — des données très détaillées, coûteuses à stocker — et indicateurs agrégés faciles à surveiller.
Pistes à découvrir
Une piste consiste à propager le même identifiant de corrélation entre l’API, le modèle, la récupération documentaire, les appels d’outils et la décision finale. On pourrait ensuite construire un graphe causal d’incident : modification de donnée, changement de modèle, dérive observée, réponse produite et action humaine.
Un protocole de recherche pourrait comparer plusieurs niveaux de journalisation et mesurer le temps moyen de diagnostic, le taux de reproduction d’un incident et l’exposition de données sensibles. Il serait également utile d’étudier des résumés de traces générés par un LLM, à condition de les confronter à la trace brute et de ne jamais les considérer comme une preuve autonome.
Du signal au playbook
Une alerte n’est pas une conclusion. Elle doit ouvrir un incident playbook, c’est-à-dire une procédure courte et répétable : vérifier la portée du problème, identifier la dernière modification, limiter le trafic si nécessaire, revenir à une version stable et documenter la décision. Une équipe ne devrait pas découvrir la procédure pendant l’incident.
Le seuil d’alerte doit aussi préciser sa fenêtre d’observation et son propriétaire. « La latence augmente » est une observation ; « au-delà de 800 ms pendant cinq minutes sur 10 % des requêtes, l’astreinte examine la version du modèle » est une règle exploitable.
Relier observabilité et objectifs de service
Une équipe peut compléter ses métriques par un SLO (Service Level Objective) : un objectif mesurable, par exemple 99 % des requêtes sous 800 ms et moins de 1 % de réponses sans preuve exploitable. Le SLO ne décrit pas tout le système ; il indique le niveau de service attendu par les utilisateurs.
Le error budget, ou budget d’erreur, traduit la marge acceptable avant de ralentir les nouvelles fonctionnalités. Si le service consomme rapidement cette marge à cause d’une dérive du modèle ou d’une dépendance instable, l’équipe doit prioriser la fiabilité et l’analyse de cause. Cette règle relie directement les signaux techniques aux décisions de développement.
Pour un service génératif, ajoutez des signaux propres au modèle : taux de refus, longueur des réponses, couverture des citations, appels d’outils échoués, coût par requête et proportion de réponses révisées par un humain. Une hausse de la disponibilité n’est pas suffisante si la qualité ou la traçabilité diminue.
Une architecture minimale peut être lue comme une chaîne de preuve :
Client → API Gateway → Retrieval Service → Model Service → Policy Check
  └────────────── correlation ID / trace ID propagé à chaque étape ──────────────┘
À chaque étape, l’équipe doit décider ce qui mérite un span, ce qui doit rester dans un log restreint et ce qui peut être agrégé en métrique. Il ne faut pas copier le texte sensible de l’utilisateur dans tous les systèmes. Un identifiant, une version de modèle, un statut et une durée peuvent souvent suffire pour diagnostiquer le parcours.
Un bon test consiste à supprimer volontairement un service ou à introduire une latence artificielle. Si l’équipe ne peut pas retrouver l’étape responsable en quelques minutes, l’instrumentation est encore trop faible ou trop dispersée.
Une boucle d’amélioration
Après chaque incident, ajoutez un cas de test reproductible, une métrique ou une condition de déploiement. L’observabilité devient alors une mémoire technique : elle ne sert pas seulement à surveiller le service, mais à améliorer la prochaine version avec des preuves issues de la précédente.
Sources et prolongements