Agentic AI · Multi-agents · Contrôle · 8 septembre 2026
L’agentic AI ne doit pas devenir autonome par défaut
Billet d’opinion
Question de départ. Faut-il vraiment donner plus d’autonomie aux agents avant d’avoir défini leurs limites et leurs conditions d’arrêt ?
L’autonomie d’un agent est une capacité à encadrer, pas une récompense automatique : elle doit être graduée, observable et réversible.
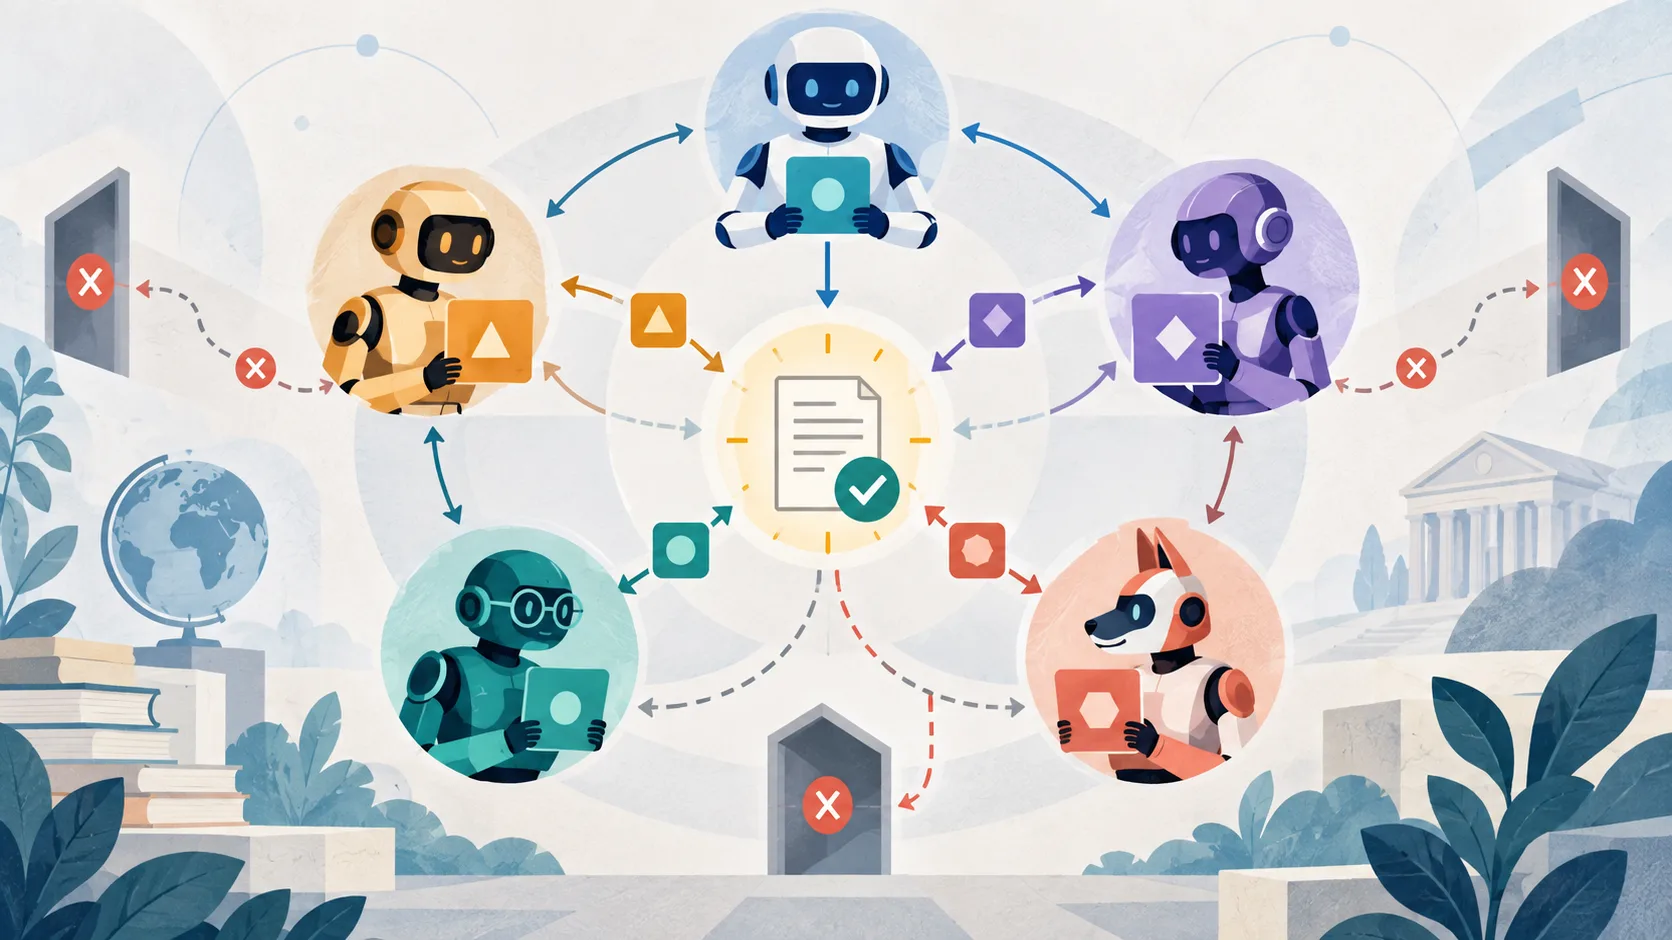
Le terme agentic AI est devenu une promesse commerciale avant de devenir une discipline d’ingénierie. Un agent peut planifier, appeler un outil, mémoriser un état et déléguer une tâche à un autre agent. Mais la capacité à agir ne dit rien, à elle seule, sur la capacité à s’arrêter correctement.
Mon opinion est simple : l’autonomie ne devrait jamais être activée par défaut. Elle devrait être gagnée progressivement, après des tests qui montrent que l’agent comprend ses permissions, signale ses incertitudes et accepte une interruption.
Un agent n’est pas un collègue numérique
Cette comparaison est séduisante, mais elle masque une différence importante. Un collègue comprend généralement les conséquences sociales d’une action et peut négocier son mandat. Un agent exécute une politique produite par du code, un modèle et un contexte. Si son rôle est ambigu, il peut poursuivre l’objectif local tout en dégradant le système global.
Dans un multi-agent system, le risque augmente : un agent peut déléguer à un autre, qui appelle un outil, qui modifie une donnée. La responsabilité devient difficile à reconstruire si les messages, les permissions et les conditions de sortie ne sont pas journalisés.
Je préfère l’autonomie graduée
Une architecture raisonnable peut définir plusieurs niveaux :
| Niveau | Capacité | Validation |
|---|---|---|
| Observation | Lire des données et proposer un plan | Toujours visible par un humain |
| Simulation | Tester un appel sans effet réel | Résultat contrôlé |
| Action limitée | Modifier un périmètre réversible | Règles et budget |
| Action sensible | Agir sur des données ou personnes | Confirmation explicite |
Cette graduated autonomy, ou autonomie graduée, est moins spectaculaire qu’un agent qui « fait tout », mais elle facilite l’apprentissage. L’équipe sait quel niveau a échoué et peut revenir au niveau précédent sans supprimer toute l’expérimentation.
L’arrêt est une fonctionnalité
Un agent fiable doit exposer un kill switch, une commande d’arrêt indépendante de son propre raisonnement. Il doit aussi avoir un budget de temps, de tokens, d’appels d’outils et de modifications. Une boucle sans limite n’est pas de l’autonomie ; c’est une dette opérationnelle.
Le test que je voudrais voir
Avant d’augmenter les permissions d’un agent, je lui ferais passer quatre tests :
- permission retirée au milieu d’une tâche ;
- outil indisponible ou réponse contradictoire ;
- interruption humaine pendant une délégation ;
- budget presque épuisé avec plusieurs plans encore possibles.
Le résultat attendu n’est pas que l’agent trouve toujours une solution. Il doit plutôt arrêter proprement, expliquer ce qui manque, ne pas contourner la permission et conserver une trace de ses actions. Cette capacité relève de la fail-safe behavior, un comportement qui met le système dans un état sûr en cas d’incertitude.
L’objection est connue : trop de contrôles rendent l’agent inutile. Je répondrais que l’autonomie doit être comparée à une procédure humaine complète, et non à une démonstration idéale. Un agent qui nécessite une validation sur une action sensible peut tout de même faire gagner du temps sur la préparation, la recherche et la simulation.
Je voudrais voir davantage de benchmarks qui mesurent le comportement après interruption, la gestion d’une permission retirée et la capacité à expliquer une délégation. La réussite ne devrait pas être « l’agent a terminé la tâche », mais « l’agent a terminé la tâche dans son périmètre, avec des preuves et une sortie propre ».
L’avenir des agents ne dépendra donc pas seulement de leur intelligence. Il dépendra de notre capacité à concevoir des limites que les systèmes peuvent comprendre et que les humains peuvent réellement faire respecter.
Sources et prolongements