MLOps · 6 juillet 2026
Installation de MLFLOW
Méthode
Question de départ. Quelles traces minimales faut-il conserver pour reprendre une expérience ML sans perdre son contexte ?
Guide pratique pour installer MLflow localement sous Ubuntu dans un environnement virtuel Python, démarrer son serveur de suivi SQLite et enregistrer un premier run.
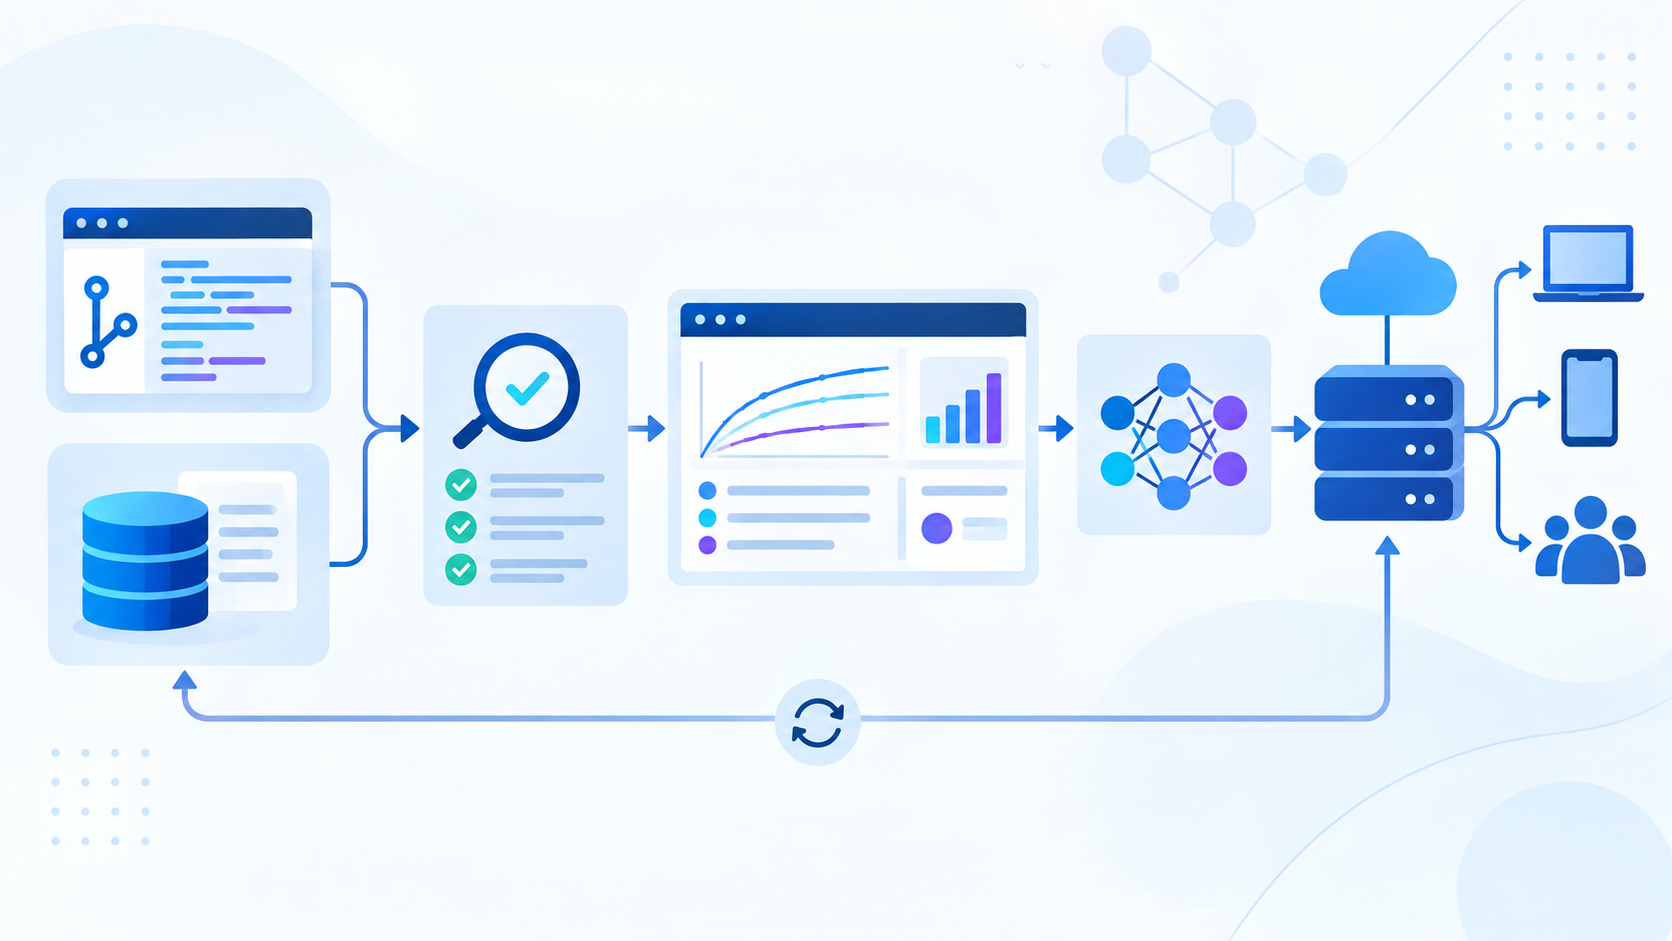
Installer MLflow sur Ubuntu avec un environnement virtuel Python
MLflow est une plateforme open source destinée à l’experiment tracking — le suivi structuré des expérimentations —, à la gestion des modèles et, plus généralement, au cycle de vie des systèmes d’intelligence artificielle. Ce tutoriel présente une installation locale simple sous Ubuntu/Linux. À la fin, un serveur MLflow fonctionnera sur votre machine et son interface sera accessible depuis un navigateur.
Résumé
Ce tutoriel accompagne l’installation complète de MLflow dans un environnement virtuel Python sous Ubuntu/Linux. Il explique comment vérifier les prérequis, isoler les dépendances, installer MLflow, démarrer un serveur local avec une base SQLite, puis ouvrir son interface Web.
La dernière étape vérifie le fonctionnement de la chaîne avec un premier run, c’est-à-dire une exécution enregistrée, contenant des paramètres et des métriques. Le guide présente également la sauvegarde des dépendances, les problèmes courants et les limites de sécurité d’une configuration destinée à l’apprentissage et au développement individuel.
Configuration testée — Ubuntu/Linux, Python 3.12 et MLflow 3.16.0. Les commandes restent valables pour les versions récentes de Python prises en charge par MLflow.
Ce que nous allons installer
L’installation utilisera quatre éléments :
- Python 3 et le module
venv; - un environnement virtuel nommé
.venv; - le paquet Python
mlflow; - un serveur local utilisant SQLite pour conserver les métadonnées.
Pour ce scénario local, MLflow crée par défaut une base mlflow.db et sert l’interface Web ainsi que l’API REST à l’adresse http://127.0.0.1:5000.
La question de recherche derrière l’installation
Installer MLflow ne rend pas une expérience reproductible par magie. La question intéressante est plutôt : quelles traces minimales permettent à une autre personne de comprendre, comparer et reprendre un entraînement plusieurs semaines plus tard ?
MLflow Tracking enregistre les parameters — les choix d’entrée comme le learning rate —, les metrics — les résultats numériques comme l’accuracy —, les versions de code et les artifacts — fichiers produits comme un modèle, une matrice de confusion ou un rapport. La base de suivi décrit les événements et l’artifact store conserve les fichiers plus volumineux. Cette séparation permet de commencer localement, puis d’évoluer vers un serveur partagé, une base PostgreSQL et un stockage d’artefacts distant lorsque les besoins de l’équipe augmentent.
Il faut néanmoins compléter le run : un score seul ne dit pas quelle donnée a été utilisée, quelle transformation a été appliquée, ni pourquoi un modèle a été retenu. Une expérience utile doit donc relier le run à un commit Git, à un identifiant de jeu de données, à la configuration d’exécution et à une note interprétant les résultats.
1. Vérifier les prérequis
Ouvrez un terminal et vérifiez la version de Python :
python3 --versionUne version récente de Python 3 doit être affichée. Si la commande venv n’est pas disponible, installez le paquet correspondant :
sudo apt update
sudo apt install python3-venv
Créez ensuite un répertoire de travail :
mkdir -p ~/projets/mlflow-demo
cd ~/projets/mlflow-demo
2. Créer et activer l’environnement virtuel
Un environnement virtuel isole MLflow et ses dépendances des autres projets Python installés sur la machine.
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip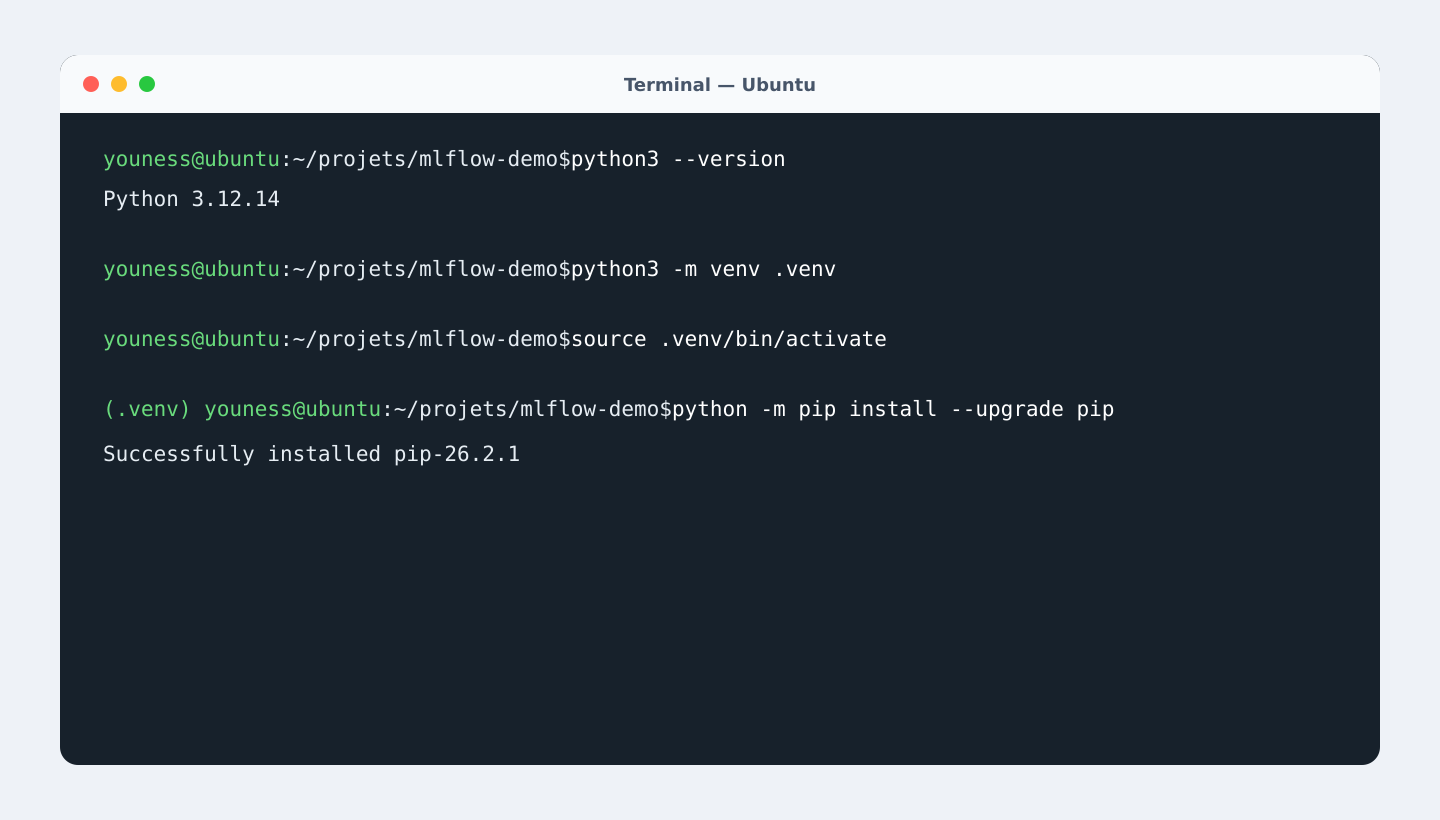
Une fois l’environnement activé, le préfixe (.venv) apparaît normalement au début de l’invite du terminal. Utiliser python -m pip garantit que pip appartient bien à l’interpréteur Python actif.
3. Installer MLflow
Installez MLflow depuis PyPI :
pip install mlflowVérifiez ensuite l’installation :
mlflow --version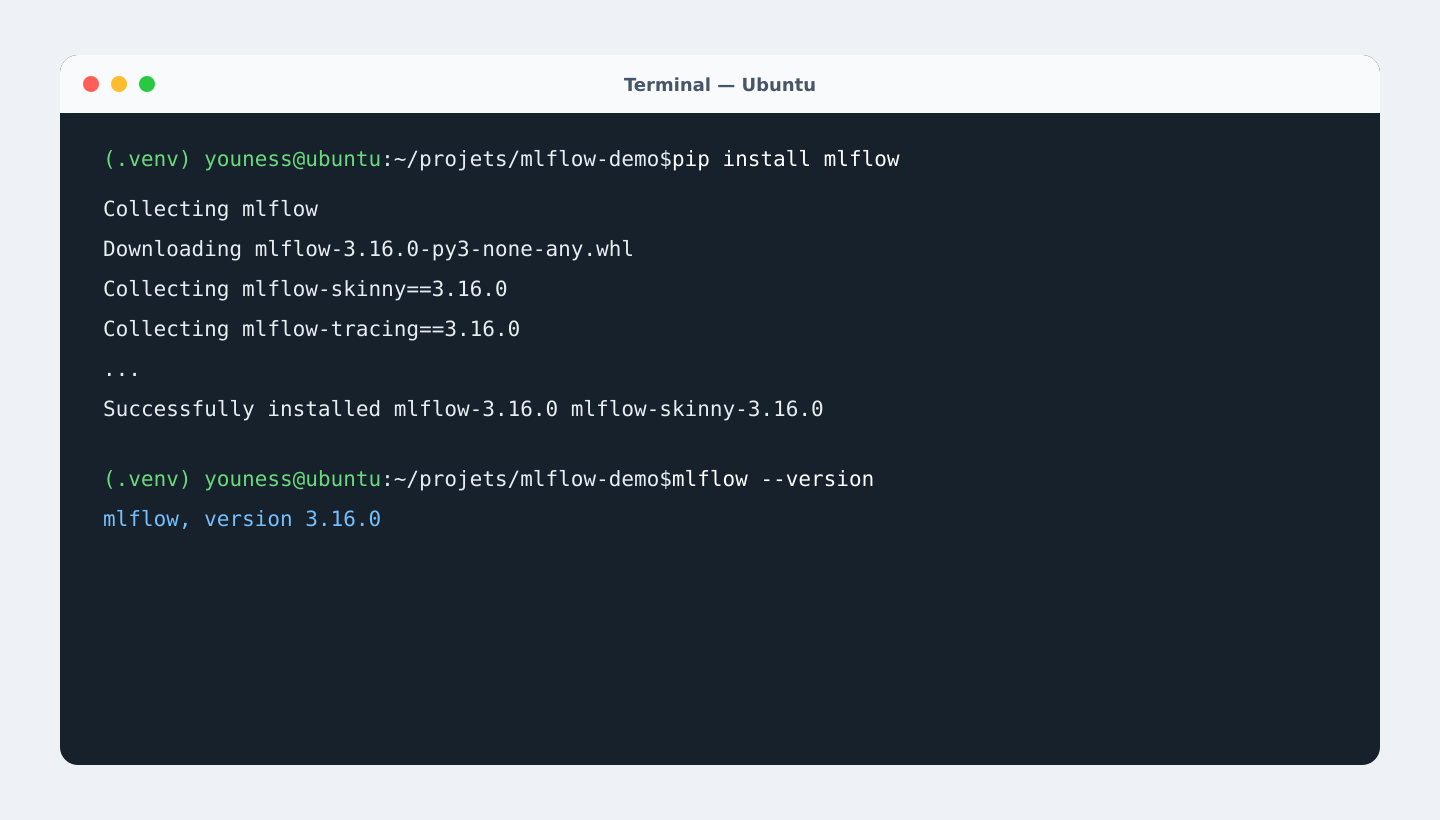
La version exacte peut être différente. Pour un projet reproductible, enregistrez les dépendances résolues :
pip freeze > requirements.txtVous pourrez les réinstaller ultérieurement avec :
pip install -r requirements.txt4. Démarrer le serveur local
Depuis le répertoire ~/projets/mlflow-demo, exécutez :
mlflow server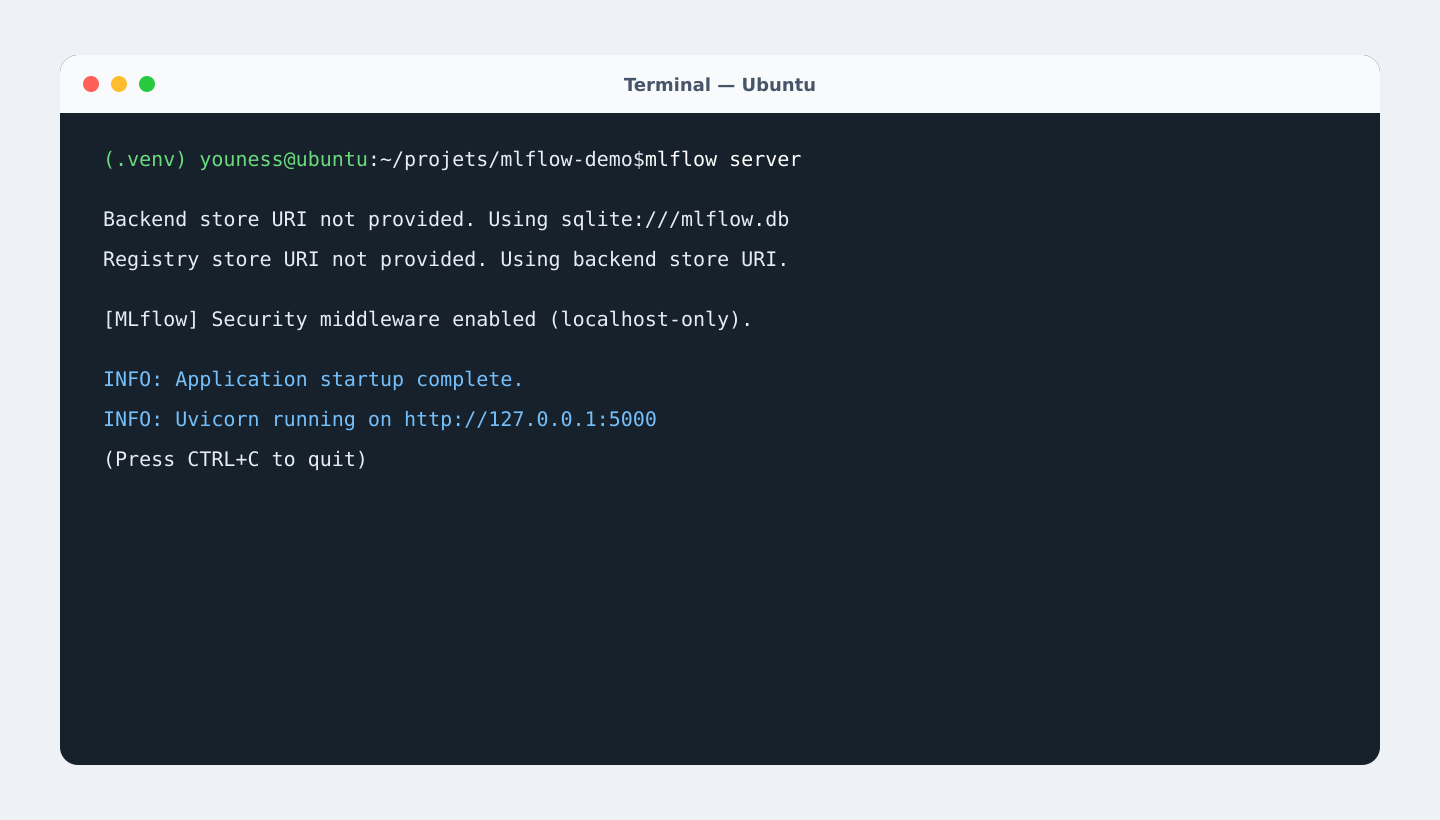
Le message important est le suivant :
Uvicorn running on http://127.0.0.1:5000Tant que ce terminal reste occupé, le serveur continue de fonctionner. Pour l’arrêter, utilisez Ctrl+C.
Que crée MLflow dans le répertoire courant ?
Dans sa configuration locale par défaut, MLflow utilise notamment :
mlflow.db: base SQLite contenant les métadonnées des expériences et des runs ;mlartifacts/: répertoire local destiné aux artefacts.
Ces éléments ne doivent généralement pas être ajoutés à Git. Vous pouvez compléter votre fichier .gitignore :
.venv/
mlflow.db
mlartifacts/
5. Ouvrir l’interface Web
Ouvrez un navigateur, puis rendez-vous à l’adresse suivante :
http://127.0.0.1:5000L’interface permet de consulter les expériences, les runs, les paramètres, les métriques et les artefacts enregistrés.
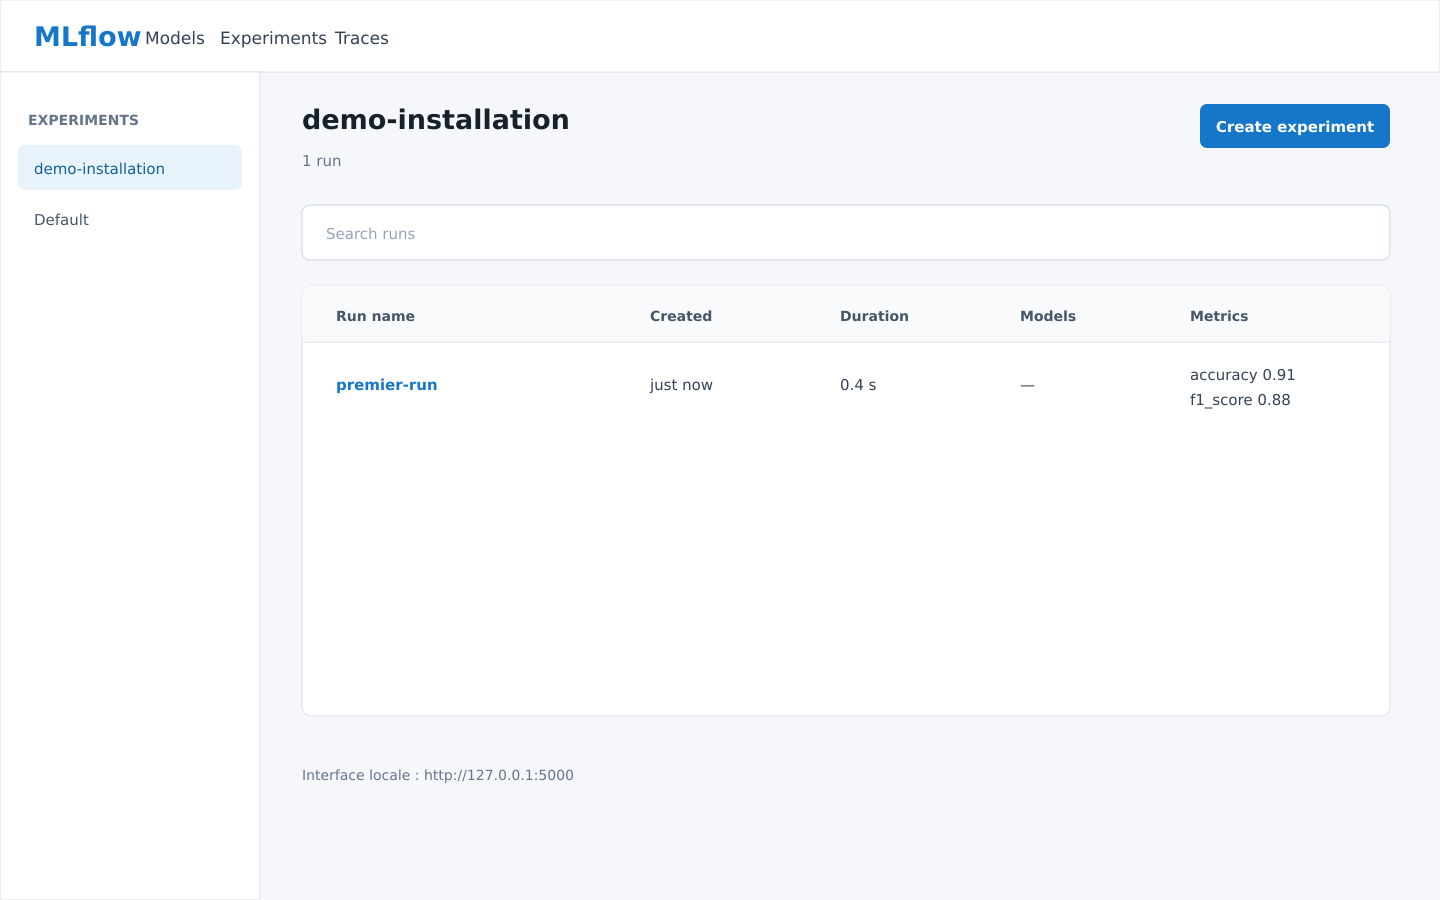
Au premier lancement, l’interface peut être vide. C’est normal : aucun run n’a encore été enregistré.
6. Vérifier le fonctionnement avec un premier run
Conservez le serveur actif et ouvrez un second terminal. Revenez dans le projet, activez l’environnement, puis définissez l’adresse du serveur :
cd ~/projets/mlflow-demo
source .venv/bin/activate
export MLFLOW_TRACKING_URI=http://127.0.0.1:5000
Créez un fichier test_mlflow.py :
import mlflow

mlflow.set_experiment("demo-installation")

with mlflow.start_run(run_name="premier-run"):
    mlflow.log_param("modele", "regression-logistique")
    mlflow.log_param("seed", 42)
    mlflow.log_metric("accuracy", 0.91)
    mlflow.log_metric("f1_score", 0.88)

print("Run enregistré dans MLflow.")
Exécutez le script :
python test_mlflow.pyActualisez ensuite l’interface. L’expérience demo-installation doit contenir un run nommé premier-run, avec ses paramètres et ses métriques.
Lire un run comme une expérience scientifique
Un run n’est pas seulement une ligne dans l’interface. Il constitue une unité d’observation. Pour pouvoir comparer deux runs, il faut connaître au moins :
- la question ou l’hypothèse testée ;
- les paramètres contrôlés, comme le nombre d’arbres ou le
learning rate; - les données utilisées et leur version ;
- les métriques retenues et leur mode de calcul ;
- les artefacts produits, par exemple un modèle ou une courbe ;
- le commit Git et l’environnement logiciel.
Cette discipline transforme MLflow en experiment notebook partagé. Le tableau de bord montre les nombres, mais le contexte explique pourquoi ces nombres sont comparables. Sans ce contexte, deux runs peuvent afficher une accuracy proche tout en ayant utilisé des données, des prétraitements ou des splits différents.
Un premier objectif réaliste est donc de définir un minimum reproducible run : un run qui contient assez de métadonnées pour qu’une autre personne puisse refaire l’expérience, identifier les différences et comprendre la décision de conserver ou d’écarter le modèle.
Dans le script précédent, on peut compléter le run avec des tags et une référence de code :
import subprocess
import mlflow

commit = subprocess.check_output(
    ["git", "rev-parse", "--short", "HEAD"], text=True
).strip()

with mlflow.start_run(run_name="premier-run-complet"):
    mlflow.set_tag("git_commit", commit)
    mlflow.set_tag("dataset_version", "customers-v3")
    mlflow.log_params({"seed": 42, "learning_rate": 0.01})
    mlflow.log_metrics({"accuracy": 0.91, "f1_score": 0.88})
L’intérêt n’est pas d’ajouter des champs pour remplir l’interface. C’est de pouvoir expliquer, plusieurs semaines plus tard, pourquoi deux résultats diffèrent. Une bonne pratique consiste aussi à écrire une courte note dans le run : hypothèse, observation, limite et décision suivante.
Résolution des problèmes courants
La commande mlflow est introuvable
Vérifiez que l’environnement virtuel est actif, puis relancez l’installation :
source .venv/bin/activate
python -m pip install mlflow
python -m mlflow --version
Le port 5000 est déjà utilisé
Choisissez un autre port, par exemple 5050 :
mlflow server --port 5050L’interface sera alors disponible sur http://127.0.0.1:5050.
Le schéma SQLite doit être mis à niveau
Après une mise à jour de MLflow, une ancienne base peut nécessiter une migration. Sauvegardez d’abord le fichier, puis suivez la procédure documentée par MLflow :
cp mlflow.db mlflow.db.backup
mlflow db upgrade sqlite:///mlflow.db
Sécurité et limites de cette configuration
Le serveur est volontairement lié à 127.0.0.1 : il n’accepte que les connexions provenant de la machine locale. Ce réglage est adapté à l’apprentissage et au développement individuel.
N’utilisez pas --host 0.0.0.0 pour exposer MLflow sans avoir configuré les hôtes autorisés, les origines CORS, l’authentification et HTTPS. Pour une utilisation collective ou en production, préférez une base PostgreSQL ou MySQL, un stockage d’artefacts adapté et une couche de sécurité telle qu’un reverse proxy ou un VPN.
Technologies complémentaires et pistes à explorer
MLflow peut devenir le centre du suivi sans être l’unique composant de la chaîne. Git ou DVC peuvent conserver le code et les versions de données, un catalogue de données peut documenter le data lineage, et OpenTelemetry peut relier une expérimentation à des traces d’exécution lorsqu’elle devient un service. Le Model Registry organise les versions de modèles et leur passage entre des étapes comme Staging et Production, mais son intérêt dépend de la qualité des tests, des critères de promotion et de la possibilité de revenir à une version précédente.
Une expérimentation pédagogique consiste à exécuter trois fois le même entraînement : sans suivi, avec seulement les métriques, puis avec paramètres, données, artefacts et note de contexte. On mesure ensuite le temps nécessaire à une autre personne pour reproduire le résultat et expliquer une différence. D’autres pistes sont possibles : détecter automatiquement les expériences incomplètes, comparer les coûts énergétiques avec la qualité obtenue, ou utiliser un agent pour proposer des expériences suivantes tout en laissant la validation finale à un chercheur.
Conclusion
MLflow est maintenant installé dans un environnement Python isolé. Vous disposez d’un serveur local, d’une interface Web et d’un premier run permettant de vérifier la chaîne complète. Cette installation constitue une base pertinente pour découvrir le suivi d’expériences avant de passer à une architecture MLOps partagée.
Références
Sources et prolongements