RL profond · Multi-agents · 12 avril 2026
Explorer en RL profond sans franchir la limite
Hypothèse
Question de départ. Comment une politique coopérative peut-elle apprendre sans franchir une frontière de sécurité ?
Une politique coopérative doit apprendre à progresser, mais aussi à reconnaître les actions qui ne sont jamais acceptables.
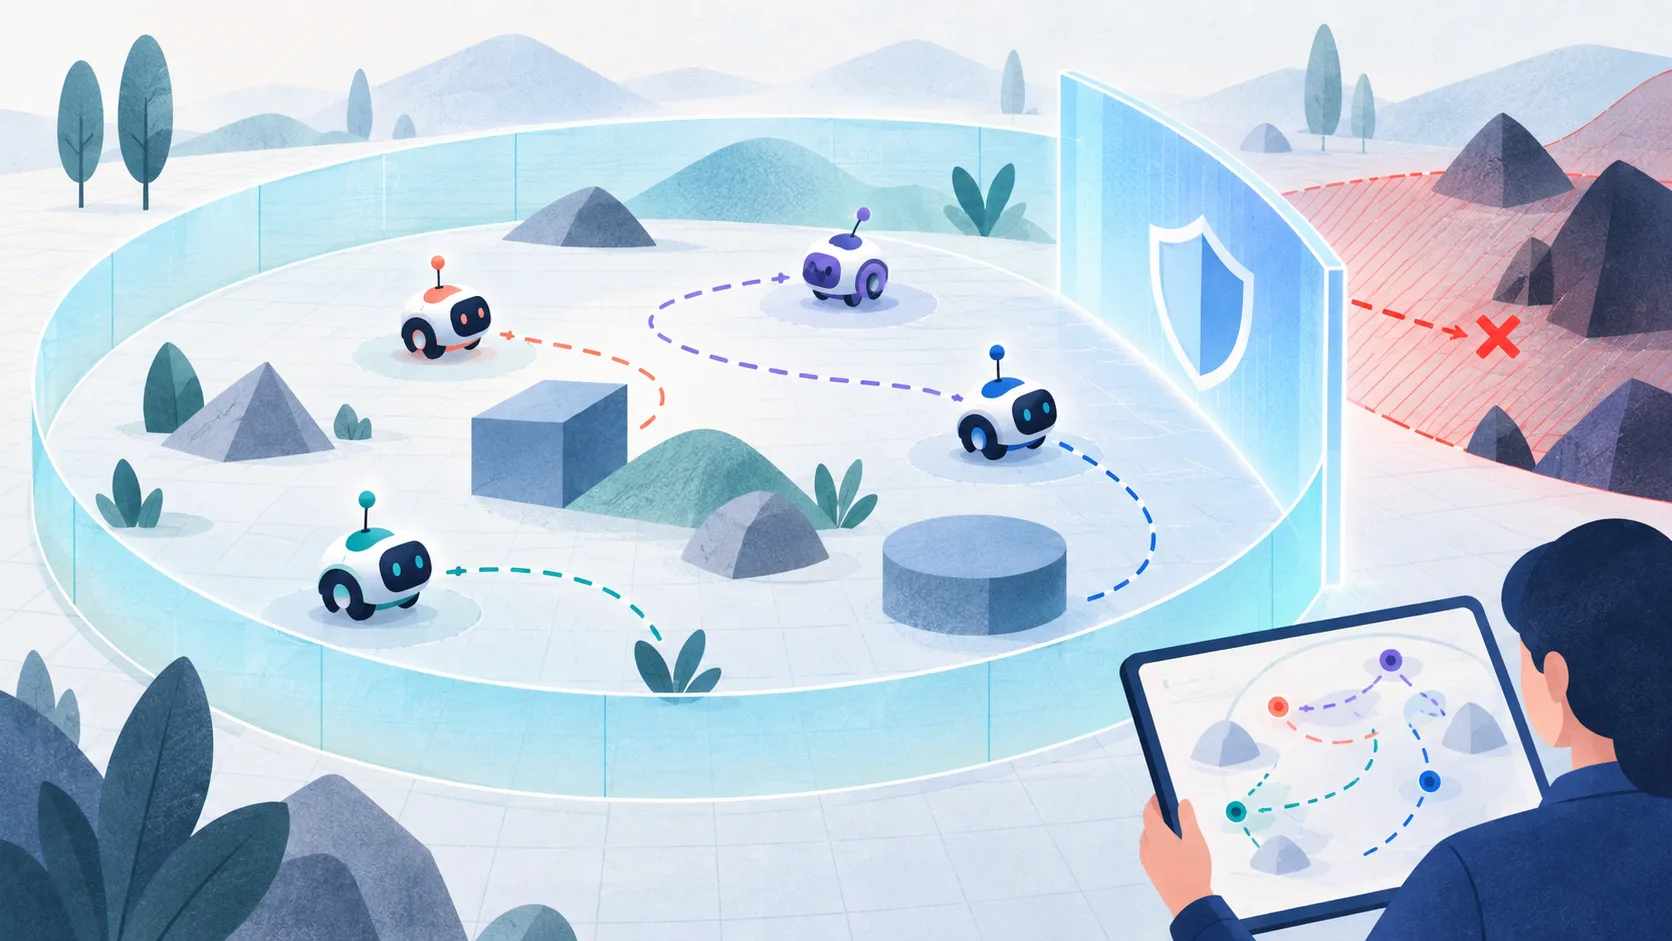
Une politique de reinforcement learning (RL), ou apprentissage par renforcement, peut améliorer sa reward — la récompense numérique utilisée pour apprendre — tout en adoptant une stratégie dangereuse. Le problème apparaît lorsque cette récompense résume mal le coût d’une collision, d’une violation de budget ou d’une action impossible à annuler. En RL coopératif, cette difficulté se multiplie : plusieurs agents peuvent prendre ensemble une décision que chacun semblait pouvoir justifier isolément.
Le terme safe exploration désigne précisément le fait d’explorer de nouvelles stratégies sans franchir certaines limites non négociables. C’est différent d’une simple pénalité dans la reward : une pénalité rend une action moins attractive, alors qu’un safety constraint peut l’interdire ou déclencher une action de récupération.
Ce que les technologies permettent déjà
Un protocole expérimental peut s’appuyer sur Gymnasium pour décrire l’environnement, PettingZoo pour les interactions multi-agents et des bibliothèques comme Stable-Baselines3 ou RLlib pour comparer les politiques. Des approches de constrained RL — RL avec contraintes explicites —, de shielded RL — RL protégé par un filtre externe —, de contrôle par fonctions barrière ou d’apprentissage hors ligne proposent déjà de séparer performance et contraintes.
Elles ne répondent toutefois pas à la question centrale : que faire lorsqu’une contrainte est incomplète, qu’un agent n’observe pas l’état réel ou que le garde-fou devient le principal facteur de blocage ? La question de recherche peut être formulée ainsi : un mécanisme de sécurité indépendant améliore-t-il la robustesse du collectif sans diminuer sa capacité à apprendre des stratégies nouvelles ?
Définir l’enveloppe de sécurité
Avant de choisir l’algorithme, séparez trois catégories d’actions :
- les actions toujours autorisées ;
- les actions possibles mais soumises à une vérification ;
- les actions interdites, même si elles améliorent momentanément la récompense.
Cette enveloppe doit être exprimée dans l’environnement d’entraînement, pas seulement dans une consigne adressée à l’agent. Elle peut prendre la forme d’un action mask — une liste d’actions momentanément autorisées —, d’un budget, d’une contrainte d’état ou d’un contrôleur externe.
Séparer proposition et autorisation
Une architecture robuste laisse la politique proposer une action, puis demande à un garde-fou indépendant de vérifier sa validité.
action = policy.observe_and_propose(state)

if safety_filter.accepts(state, action, budget):
    next_action = action
else:
    next_action = safety_filter.recovery_action(state)

environment.step(next_action)
Le filtre ne doit pas être invisible. Il faut enregistrer l’action proposée, la décision du filtre, la raison d’un refus et l’action de récupération, ou recovery action. Sans cette trace, une amélioration du score peut masquer une augmentation des interventions de sécurité.
Mesurer autre chose que la récompense
Un tableau d’évaluation minimal comporte au moins :
- la récompense moyenne et sa dispersion ;
- le taux de violation par épisode ;
- le nombre d’interventions du garde-fou ;
- le coût de communication entre agents ;
- le taux de réussite dans les scénarios limites ;
- la proportion d’épisodes qui terminent par récupération ou arrêt.
La tendance recherchée n’est pas seulement « plus de récompense ». C’est une progression de la performance avec moins de violations et moins d’interventions forcées.
Une erreur fréquente consiste à comparer deux politiques sur une moyenne globale. Cette moyenne peut masquer quelques épisodes catastrophiques. Il est préférable de publier aussi le worst-case profile, c’est-à-dire le comportement dans les scénarios les plus défavorables : budget presque épuisé, observation manquante, agent retardé ou communication interrompue.
Pour chaque épisode, conservez au minimum l’état initial, les actions proposées, les actions refusées, la raison du refus et le résultat final. Ces trajectoires servent à comprendre si le garde-fou protège réellement l’environnement ou s’il empêche simplement l’agent d’apprendre.
Construire un benchmark utile
Un benchmark ne doit pas seulement fournir un score ; il doit rendre visibles les compromis. Un protocole reproductible peut utiliser trois niveaux :
- Nominal : environnement stable, observation complète et agents synchronisés ;
- Perturbé : bruit, retard, changement d’obstacle ou réduction du budget ;
- Critique : action presque irréversible, conflit entre objectifs ou perte d’un agent.
Pour chaque niveau, comparez une politique sans filtre, une politique avec pénalité dans la reward et une politique avec shield indépendant. Le résultat intéressant n’est pas forcément la politique qui obtient la meilleure récompense, mais celle qui conserve une capacité d’action acceptable lorsque l’environnement sort du cas nominal.
Un protocole reproductible
Pour rendre la comparaison crédible, publiez l’environnement, les seeds, le nombre d’épisodes, la définition exacte d’une violation et les trajectoires refusées. Un tableau minimal peut prendre cette forme :
| Configuration | Reward moyenne | Violations / épisode | Interventions du shield | Réussite en scénario critique |
|---|---|---|---|---|
| Sans filtre | à mesurer | à mesurer | 0 | à mesurer |
| Pénalité dans la reward | à mesurer | à mesurer | 0 | à mesurer |
| Shield externe | à mesurer | à mesurer | à mesurer | à mesurer |
Les cellules « à mesurer » sont importantes : il ne faut pas inventer un résultat pour rendre l’hypothèse convaincante. Le résultat de l’expérience doit pouvoir confirmer, nuancer ou réfuter l’idée qu’un garde-fou indépendant améliore la sécurité sans rendre la politique inutilisable.
Une objection mérite aussi d’être prise au sérieux : un shield trop strict peut empêcher l’agent de découvrir une stratégie légitime. Il faut donc mesurer les actions refusées à tort, et pas seulement les violations évitées.
Pistes à découvrir
Un benchmark utile devrait varier séparément la difficulté de la tâche, le nombre d’agents, le budget de communication et la sévérité du garde-fou. Il pourrait comparer une pénalisation dans la récompense, un masque d’actions et un contrôleur externe, en publiant les trajectoires refusées plutôt qu’un seul score final.
Trois pistes sont particulièrement prometteuses : apprendre une politique de récupération à partir des interventions humaines, estimer l’incertitude lorsque les agents perdent une observation, et étudier la formation de coalitions qui respectent une contrainte globale alors que chaque agent ne voit qu’une partie du système. Le passage à un robot ou à un service réel ne devrait intervenir qu’après des tests de transfert, de réinitialisation et de reprise manuelle.
Tester le transfert avant le terrain
La simulation doit contenir des cas que la politique n’a pas vus exactement : observation manquante, agent retardé, budget presque épuisé, obstacle déplacé et conflit entre objectifs locaux. Pour chaque scénario, documentez la réponse attendue et le comportement réellement observé.
Un transfert crédible inclut une procédure de retour arrière, un opérateur capable de reprendre la main et un seuil à partir duquel l’expérimentation s’arrête. La sécurité n’est donc pas une étape finale : elle structure le choix des environnements, des métriques et des preuves dès le premier entraînement.
Sources et prolongements