tutoriel · MLOps
Tutoriel — Construire un pipeline ML reproductible
Mettre en place un petit pipeline de machine learning versionné avec DVC, paramétré avec YAML et suivi avec MLflow.
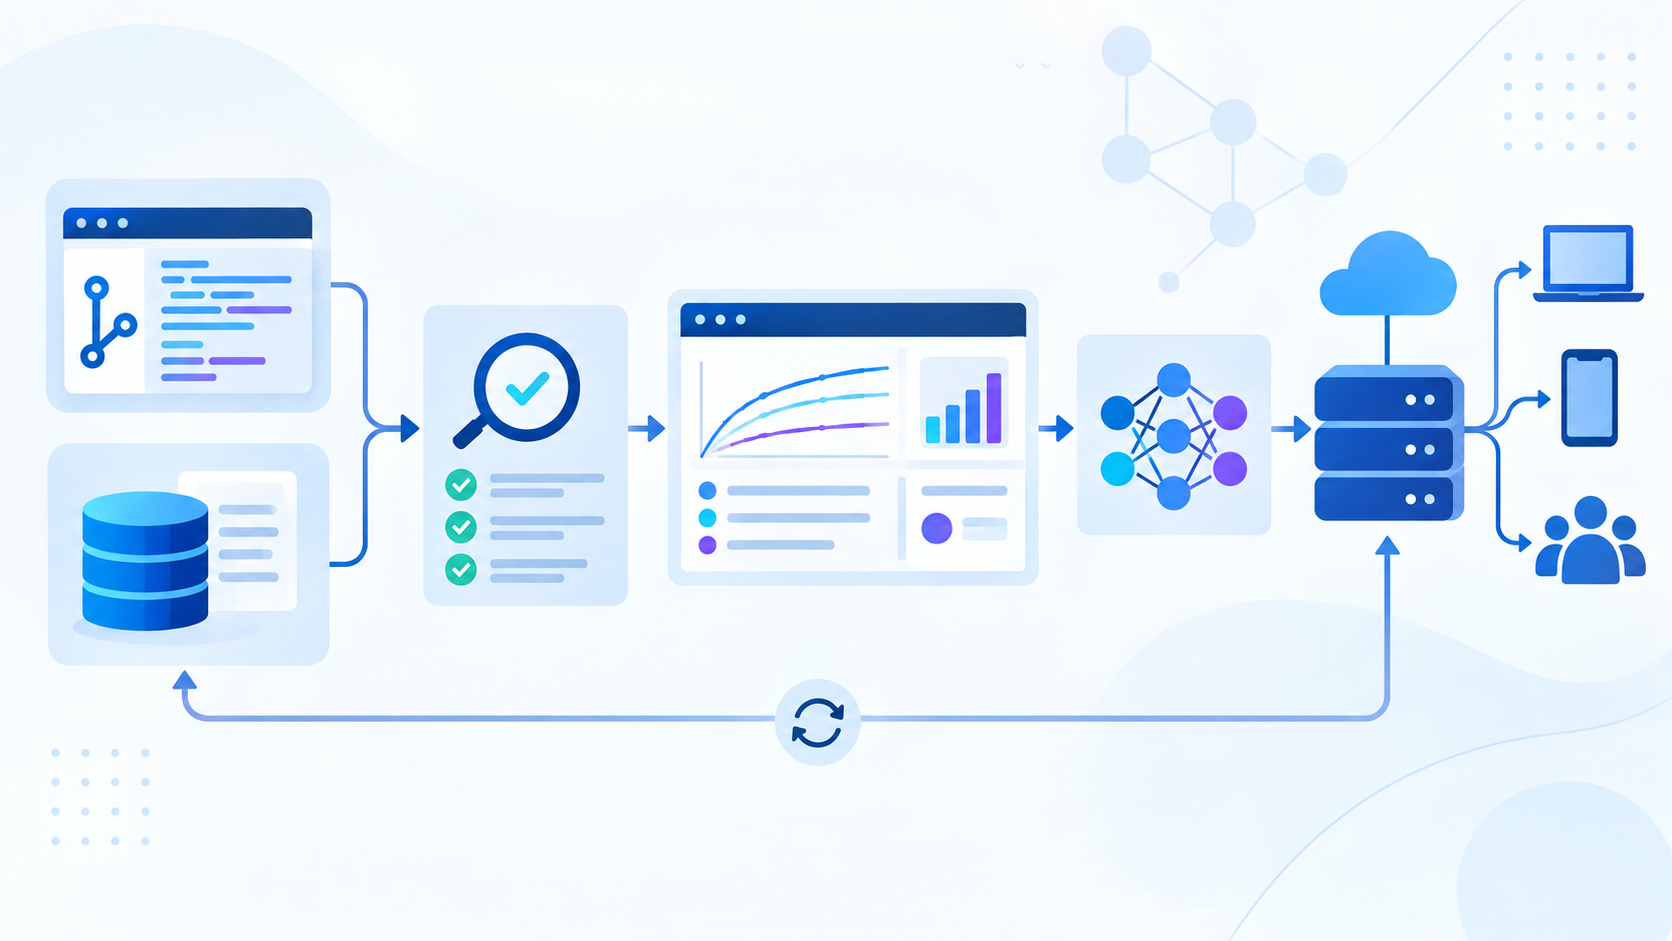
Illustration : une exécution reproductible relie les données, le code, les paramètres et les preuves produites par le modèle.
Résultat attendu
À la fin de ce tutoriel, vous disposerez d’un dépôt capable de reconstruire le même modèle à partir des mêmes entrées. La chaîne produira :
- un jeu de données généré de manière déterministe ;
- un modèle entraîné à partir de paramètres explicites ;
- un rapport de métriques et une empreinte du jeu de données ;
- une exécution MLflow consultable ;
- un graphe DVC décrivant les dépendances entre les étapes.
Le but n’est pas d’obtenir le meilleur score possible. Le but est de pouvoir répondre précisément à la question : quelle combinaison de données, de code et de paramètres a produit ce résultat ?
Prérequis et public cible
Ce guide s’adresse aux étudiants et ingénieurs qui connaissent les bases de Python et de la classification supervisée. Il est utile avant un TP de déploiement, de CI/CD ou de suivi de dérive.
Vous aurez besoin de Python 3.10 ou plus récent et de Git. DVC et MLflow sont exécutés localement ; aucun compte cloud n’est nécessaire.
1. Initialiser le projet
Créez un dépôt isolé puis un environnement virtuel :
mkdir mlops-reproductible
cd mlops-reproductible
git init
python -m venv .venv
source .venv/bin/activate          # Windows : .venv\Scripts\activate
python -m pip install --upgrade pip
python -m pip install dvc mlflow pandas scikit-learn pyyaml
mkdir -p data/raw reports src
Vérifiez les versions avant de continuer :
python --version
dvc --version
mlflow --version
Le résultat attendu est une version installée pour chacune des trois commandes. Si DVC ou MLflow n’est pas trouvé, vérifiez que l’environnement virtuel est activé.
2. Générer une donnée d’entrée déterministe
Créez le fichier src/make_dataset.py avec le contenu suivant. Le générateur utilise une graine fixe : une nouvelle exécution recrée donc exactement le même fichier.
from pathlib import Path
import csv
import random

OUTPUT = Path("data/raw/clients.csv")

def main() -> None:
    rng = random.Random(7)
    OUTPUT.parent.mkdir(parents=True, exist_ok=True)
    rows = []

    for client_id in range(1, 121):
        visits = rng.randint(1, 30)
        support_calls = rng.randint(0, 8)
        contract_months = rng.choice([1, 3, 6, 12, 24])
        churn = int(
            (support_calls >= 5 and visits <= 10)
            or (contract_months == 1 and visits <= 8)
        )
        rows.append({
            "client_id": client_id,
            "visits": visits,
            "support_calls": support_calls,
            "contract_months": contract_months,
            "churn": churn,
        })

    with OUTPUT.open("w", newline="", encoding="utf-8") as handle:
        writer = csv.DictWriter(handle, fieldnames=rows[0].keys())
        writer.writeheader()
        writer.writerows(rows)

    print(f"{len(rows)} lignes écrites dans {OUTPUT}")

if __name__ == "__main__":
    main()
Lancez l’étape et contrôlez la preuve produite :
python src/make_dataset.py
head -5 data/raw/clients.csv
sha256sum data/raw/clients.csv
Le fichier doit contenir 120 clients, une ligne d’en-tête et les colonnes visits, support_calls, contract_months et churn.
3. Déclarer les paramètres
Créez params.yaml. Les choix expérimentaux sont ainsi séparés du code :
split:
  test_size: 0.25
  random_state: 7
model:
  C: 1.0
  max_iter: 500
Une modification de test_size, de C ou de max_iter doit être visible dans l’historique Git et provoquer une nouvelle exécution DVC.
4. Entraîner et enregistrer les preuves
Créez src/train.py :
from hashlib import sha256
from pathlib import Path
import json

import mlflow
import pandas as pd
import yaml
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score
from sklearn.model_selection import train_test_split

DATA = Path("data/raw/clients.csv")
METRICS = Path("reports/metrics.json")
MANIFEST = Path("reports/manifest.json")

def digest(path: Path) -> str:
    return sha256(path.read_bytes()).hexdigest()

def main() -> None:
    params = yaml.safe_load(Path("params.yaml").read_text(encoding="utf-8"))
    frame = pd.read_csv(DATA)
    features = ["visits", "support_calls", "contract_months"]
    x_train, x_test, y_train, y_test = train_test_split(
        frame[features],
        frame["churn"],
        test_size=float(params["split"]["test_size"]),
        random_state=int(params["split"]["random_state"]),
        stratify=frame["churn"],
    )
    model = LogisticRegression(
        C=float(params["model"]["C"]),
        max_iter=int(params["model"]["max_iter"]),
    )

    mlflow.set_experiment("mlops-reproductible")
    with mlflow.start_run() as run:
        model.fit(x_train, y_train)
        prediction = model.predict(x_test)
        metrics = {
            "accuracy": round(float(accuracy_score(y_test, prediction)), 4),
            "f1": round(float(f1_score(y_test, prediction, zero_division=0)), 4),
        }
        mlflow.log_params({
            "test_size": params["split"]["test_size"],
            "random_state": params["split"]["random_state"],
            "C": params["model"]["C"],
            "max_iter": params["model"]["max_iter"],
        })
        mlflow.log_metrics(metrics)

        METRICS.parent.mkdir(parents=True, exist_ok=True)
        METRICS.write_text(
            json.dumps(metrics, indent=2) + "\n", encoding="utf-8"
        )
        MANIFEST.write_text(json.dumps({
            "run_id": run.info.run_id,
            "data": str(DATA),
            "data_sha256": digest(DATA),
            "rows": len(frame),
            "features": features,
            "metrics": metrics,
        }, indent=2) + "\n", encoding="utf-8")

    print(json.dumps(metrics, indent=2))
    print(f"Manifest MLflow : {MANIFEST}")

if __name__ == "__main__":
    main()
Testez localement avant d’automatiser :
python src/train.py
cat reports/metrics.json
cat reports/manifest.json
La métrique n’est interprétable qu’avec son contexte : nombre de lignes, variables utilisées, paramètres et empreinte de la donnée. C’est pourquoi le manifeste accompagne le score.
5. Décrire le graphe DVC
Créez dvc.yaml :
stages:
  prepare:
    cmd: python src/make_dataset.py
    outs:
      - data/raw/clients.csv
  train:
    cmd: python src/train.py
    deps:
      - data/raw/clients.csv
      - src/train.py
      - params.yaml
    params:
      - split
      - model
    outs:
      - reports/metrics.json
      - reports/manifest.json
Initialisez DVC et laissez-le calculer le graphe :
dvc init
dvc repro
dvc status
DVC repro ne relance que les étapes dont une dépendance a changé. Après une exécution sans modification, DVC status doit indiquer que le dépôt est à jour.
Ajoutez ensuite la définition et le code à Git :
git add dvc.yaml params.yaml src data/raw reports .dvc
git commit -m "Ajoute un pipeline MLOps reproductible"
Dans un vrai projet, un stockage DVC distant (dvc remote) est ajouté pour conserver les gros fichiers hors du dépôt Git. Ce tutoriel reste volontairement local afin de rendre la première expérience portable.
6. Inspecter l’expérience MLflow
Dans un second terminal, avec l’environnement virtuel activé :
mlflow ui --backend-store-uri ./mlruns --port 5000Ouvrez http://127.0.0.1:5000. Vous devez retrouver l’expérience mlops-reproductible, les paramètres et les métriques de l’exécution. Le fichier reports/manifest.json constitue la preuve portable à conserver dans un rapport ou une CI.
7. Vérification finale
| Vérification | Preuve attendue | Décision |
|---|---|---|
| Donnée | même empreinte SHA-256 après régénération | l’entrée est déterministe |
| Pipeline | DVC status sans changement | les dépendances sont déclarées |
| Modèle | metrics.json et manifest.json présents | le résultat est archivé |
| Expérience | paramètres et métriques visibles dans MLflow | le score est traçable |
Pour vérifier le caractère reproductible, supprimez les sorties puis reconstruisez :
rm -rf data/raw reports
dvc repro
git diff --exit-code -- data/raw/clients.csv reports/metrics.json
Si la commande ne produit aucune différence, les sorties sont cohérentes avec la version suivie par Git et DVC.
Dépannage et prolongements
- DVC introuvable : activez .venv ou utilisez python -m pip install dvc.
- MLflow ne démarre pas : vérifiez l’installation puis relancez python src/train.py.
- Erreur de stratification : vérifiez qu’il existe au moins deux exemples dans chaque classe ; le générateur fourni respecte cette contrainte.
- Score instable : contrôlez d’abord random_state et l’empreinte de la donnée avant de modifier le modèle.
Extensions possibles : ajouter une étape de validation, comparer deux modèles dans MLflow, stocker les données dans un remote DVC, puis exécuter DVC repro dans GitHub Actions.