tutoriel · Management de la data
Tutoriel — Acquérir et documenter des données avec Python
Construire une chaîne Requests → réponse brute → BeautifulSoup/Pandas → CSV, avec une provenance vérifiable et un repli local.
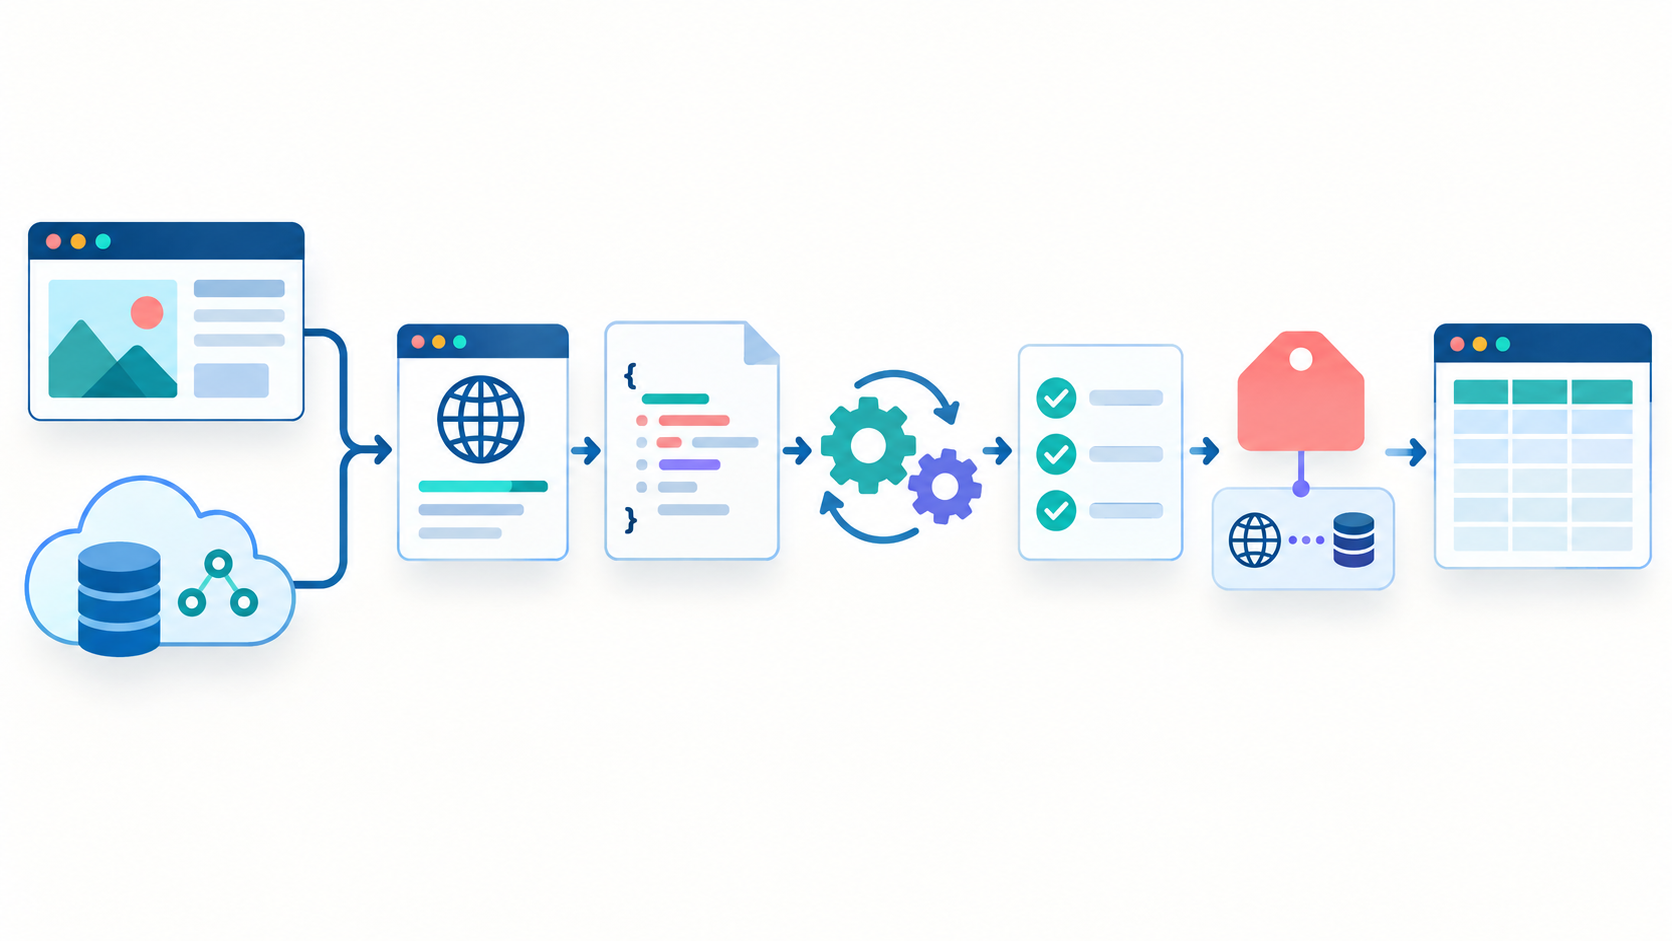
Illustration : conserver la réponse brute et son empreinte avant de produire un tableau exploitable.
Résultat attendu
Vous allez construire un mini-pipeline de collecte qui :
- interroge une API publique et conserve sa réponse brute ;
- récupère une page HTML et extrait son titre avec BeautifulSoup ;
- normalise les informations avec Pandas dans un CSV ;
- écrit un manifeste de provenance avec l’URL, le mode d’acquisition, la date et les empreintes SHA-256 ;
- fonctionne aussi sans réseau grâce à un jeu de données de repli intégré au script.
Cette organisation sépare clairement acquérir, transformer et vérifier. Une erreur réseau ne doit pas être confondue avec une erreur de parsing ou de qualité des données.
Prérequis et public cible
Le tutoriel s’adresse aux étudiants qui connaissent les bases de Python, des fichiers JSON/CSV et des tableaux de données. Aucun compte GitHub n’est nécessaire : l’API utilisée est publique et le repli local garantit une exécution en salle sans réseau.
1. Préparer le projet
mkdir collecte-provenance
cd collecte-provenance
python -m venv .venv
source .venv/bin/activate          # Windows : .venv\Scripts\activate
python -m pip install --upgrade pip
python -m pip install requests beautifulsoup4 pandas
mkdir -p data/raw data/clean reports src
L’arborescence cible est la suivante :
collecte-provenance/
├── data/
│   ├── clean/       # données transformées
│   └── raw/         # réponses originales
├── reports/         # manifeste et contrôles
└── src/
    ├── acquire.py
    └── validate.py
Les fichiers sous data/raw/ ne doivent pas être remplacés par une version nettoyée. Ils servent de témoin de ce qui a réellement été reçu.
2. Acquérir les réponses et conserver leur contexte
Créez le fichier src/acquire.py :
from datetime import datetime, timezone
from hashlib import sha256
from pathlib import Path
import json

import pandas as pd
import requests
from bs4 import BeautifulSoup

API_URL = "https://api.github.com/repos/pallets/flask"
HTML_URL = "https://example.com/"
API_FILE = Path("data/raw/repository.json")
HTML_FILE = Path("data/raw/example.html")
CSV_FILE = Path("data/clean/summary.csv")
MANIFEST_FILE = Path("reports/provenance.json")

FALLBACK_API = {
    "full_name": "fixture/demo-repository",
    "description": "Réponse locale de secours pour le tutoriel",
    "language": "Python",
    "stargazers_count": 0,
}
FALLBACK_HTML = """<!doctype html>
<html><head><title>Page locale de secours</title></head>
<body><main><h1>Collecte hors ligne</h1></main></body></html>"""


def checksum(payload: bytes) -> str:
    return sha256(payload).hexdigest()


def get_bytes(url: str, fallback: bytes) -> tuple[bytes, str, int | None]:
    try:
        response = requests.get(
            url,
            timeout=15,
            headers={"User-Agent": "academic-data-tutorial/1.0"},
        )
        response.raise_for_status()
        return response.content, "live", response.status_code
    except requests.RequestException as error:
        print(f"Réseau indisponible ({error}); utilisation du repli local.")
        return fallback, "fixture", None


def main() -> None:
    api_payload, api_mode, api_status = get_bytes(
        API_URL,
        json.dumps(FALLBACK_API, ensure_ascii=False).encode("utf-8"),
    )
    html_payload, html_mode, html_status = get_bytes(
        HTML_URL,
        FALLBACK_HTML.encode("utf-8"),
    )

    API_FILE.parent.mkdir(parents=True, exist_ok=True)
    CSV_FILE.parent.mkdir(parents=True, exist_ok=True)
    MANIFEST_FILE.parent.mkdir(parents=True, exist_ok=True)
    API_FILE.write_bytes(api_payload)
    HTML_FILE.write_bytes(html_payload)

    repository = json.loads(api_payload.decode("utf-8"))
    soup = BeautifulSoup(html_payload, "html.parser")
    page_title = soup.title.get_text(" ", strip=True) if soup.title else "Sans titre"
    heading = soup.find("h1")
    heading_text = heading.get_text(" ", strip=True) if heading else "Sans titre"

    rows = [{
        "source": "api",
        "name": repository.get("full_name", "inconnu"),
        "description": repository.get("description") or "Sans description",
        "language": repository.get("language") or "Inconnue",
        "stars": int(repository.get("stargazers_count", 0)),
    }, {
        "source": "html",
        "name": page_title,
        "description": heading_text,
        "language": "HTML",
        "stars": 0,
    }]
    pd.DataFrame(rows).to_csv(CSV_FILE, index=False)

    manifest = {
        "collected_at": datetime.now(timezone.utc).isoformat(),
        "sources": [
            {"url": API_URL, "mode": api_mode, "status": api_status,
             "sha256": checksum(api_payload), "file": str(API_FILE)},
            {"url": HTML_URL, "mode": html_mode, "status": html_status,
             "sha256": checksum(html_payload), "file": str(HTML_FILE)},
        ],
        "output": str(CSV_FILE),
        "rows": len(rows),
        "columns": list(rows[0].keys()),
    }
    MANIFEST_FILE.write_text(
        json.dumps(manifest, indent=2, ensure_ascii=False) + "\n",
        encoding="utf-8",
    )
    print(f"Réponses brutes : {API_FILE}, {HTML_FILE}")
    print(f"Tableau nettoyé : {CSV_FILE}")
    print(f"Manifeste : {MANIFEST_FILE}")


if __name__ == "__main__":
    main()
Lancez le script :
python src/acquire.py
cat data/clean/summary.csv
cat reports/provenance.json
En ligne, le manifeste indique mode: live et le code HTTP reçu. Sans connexion, il indique mode: fixture et documente explicitement le repli. Dans les deux cas, les octets réellement utilisés sont enregistrés et hachés.
3. Contrôler le schéma avant analyse
Créez src/validate.py :
from pathlib import Path
import json

import pandas as pd

CSV_FILE = Path("data/clean/summary.csv")
MANIFEST_FILE = Path("reports/provenance.json")
EXPECTED_COLUMNS = {"source", "name", "description", "language", "stars"}


def main() -> None:
    frame = pd.read_csv(CSV_FILE)
    manifest = json.loads(MANIFEST_FILE.read_text(encoding="utf-8"))
    columns = set(frame.columns)
    if columns != EXPECTED_COLUMNS:
        raise ValueError(f"Colonnes inattendues : {sorted(columns)}")
    if frame.empty or frame["name"].isna().any():
        raise ValueError("Le tableau doit contenir au moins un nom non vide.")
    if manifest["rows"] != len(frame):
        raise ValueError("Le nombre de lignes ne correspond pas au manifeste.")
    if len(manifest["sources"]) != 2:
        raise ValueError("Les deux sources doivent être documentées.")
    print(f"Validation réussie : {len(frame)} lignes, 2 sources documentées.")


if __name__ == "__main__":
    main()
Exécutez le contrôle :
python src/validate.pyLa validation doit échouer si une colonne est renommée, si le tableau est vide ou si le manifeste n’est plus aligné avec le CSV. Ce contrôle est plus fiable qu’une simple inspection visuelle.
4. Comparer les trois niveaux de données
| Niveau | Fichier | Question à poser |
|---|---|---|
| Réponse brute | data/raw/repository.json et example.html | qu’avons-nous réellement reçu ? |
| Transformation | src/acquire.py | quelles règles d’extraction avons-nous appliquées ? |
| Résultat | data/clean/summary.csv | le schéma est-il exploitable et validé ? |
Pour consulter les résultats dans un navigateur local :
python -m http.server 8000 --directory data/cleanOuvrez http://127.0.0.1:8000/summary.csv et comparez le tableau avec les réponses conservées dans data/raw/. Le CSV n’est pas une preuve suffisante à lui seul : sans les réponses brutes et le manifeste, la transformation ne peut pas être auditée.
5. Reproductibilité, limites et bonnes pratiques
- Respectez les conditions d’utilisation, les limites de débit et les règles d’accès de chaque service.
- Utilisez un délai raisonnable, un User-Agent explicite et ne collectez que les champs nécessaires.
- Enregistrez la date, l’URL, le statut et l’empreinte de chaque réponse.
- Ne placez jamais de jeton ou de donnée personnelle dans le dépôt.
- Une empreinte prouve que le fichier n’a pas changé depuis son acquisition ; elle ne prouve pas que la source est exacte ou légitime.
- Une réponse HTTP valide peut quand même contenir un schéma inattendu : validez toujours les colonnes et les valeurs essentielles.
Extensions
Vous pouvez maintenant remplacer les deux sources d’exemple par une source institutionnelle, ajouter un fichier requirements.txt, planifier l’acquisition, ou faire exécuter python src/acquire.py && python src/validate.py dans une CI. Pour une collecte régulière, versionnez le manifeste et comparez les empreintes entre deux dates plutôt que d’écraser silencieusement les réponses précédentes.