IA symbolique · LLM · RAG · MCP · 23 octobre 2026
Solveurs de contraintes dans les pipelines génératifs
Idée innovante
Question de départ. Comment ajouter des contraintes vérifiables à un pipeline génératif sans étouffer sa capacité d’exploration ?
Un LLM peut proposer ; un pipeline fiable doit encore retrouver les preuves, vérifier les règles et décider quand s’abstenir.
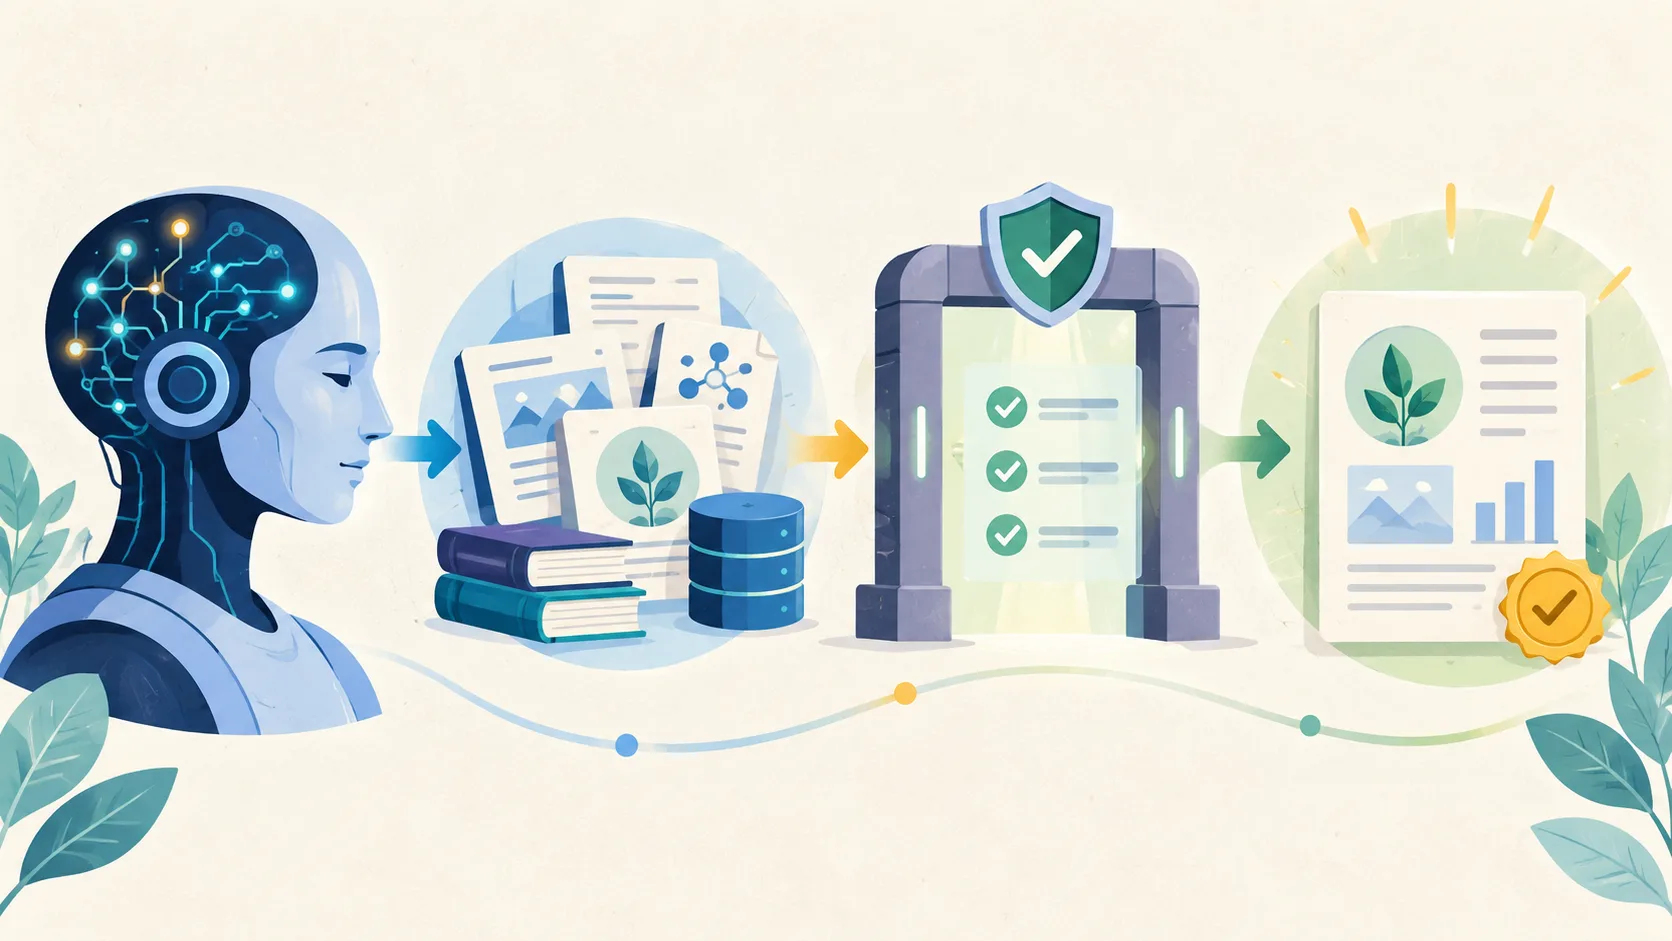
Une réponse générée peut être fluide, plausible et pourtant inutilisable. Elle peut citer un document qui n’existe pas, dépasser une limite métier ou appeler un outil avec des paramètres incohérents. La question n’est donc pas de demander au modèle de « faire attention », mais de placer des vérifications explicites autour de sa proposition. Dans ce billet, un constraint solver désigne un solveur capable de rechercher une affectation qui respecte un ensemble de contraintes ; il ne remplace pas le modèle, il vérifie une partie précise de sa proposition.
Les technologies existantes
Les structured outputs et les schémas JSON peuvent contrôler la forme d’une réponse. Pydantic ou JSON Schema vérifient les types et les champs obligatoires ; un solveur SMT comme Z3 peut tester des contraintes logiques ; un rule engine peut appliquer des seuils métier ; un index vectoriel et un reranker — modèle qui réordonne les passages récupérés — peuvent améliorer la sélection des passages dans un pipeline RAG. Les serveurs MCP facilitent l’exposition de ressources et d’outils, mais chaque appel doit encore être authentifié, limité et vérifié.
Ces outils ne poursuivent pas le même objectif. Un schéma détecte une structure invalide, un solveur teste une cohérence, et la récupération documentaire apporte un contexte : aucun ne garantit à lui seul que la réponse est pertinente. La question de recherche devient : comment combiner génération probabiliste et contraintes symboliques pour obtenir une réponse utile, vérifiable et capable de s’abstenir ?
Répartir les responsabilités
Un pipeline génératif fiable sépare au moins quatre rôles :
- le LLM produit une hypothèse ou une réponse candidate ;
- le RAG (Retrieval-Augmented Generation) récupère des passages et conserve leur provenance, c’est-à-dire la source exacte utilisée pour répondre ;
- le vérificateur applique les règles de format, de domaine et de sécurité ;
- l’orchestrateur décide de répondre, de demander une précision ou de s’abstenir, selon les résultats des vérifications.
Un serveur MCP peut exposer des outils et des ressources selon un contrat interopérable, mais il ne supprime pas la nécessité de valider les arguments, les permissions et les résultats de chaque appel.
Faire passer la preuve avant la formulation
La génération ne devrait pas être la première étape visible. Une séquence plus contrôlable ressemble à ceci :
question
  → recherche de sources
  → sélection des passages pertinents
  → proposition du LLM
  → vérification des contraintes
  → réponse avec provenance ou abstention
Les contraintes peuvent être syntaxiques — schéma JSON, champs obligatoires, types — ou sémantiques : documenter une source, refuser une action hors périmètre, ne pas inventer une valeur absente du contexte. Chaque échec doit être classé plutôt que transformé silencieusement en réponse.
On peut formaliser une réponse candidate avec un petit contrat :
{
  "answer": "...",
  "sources": ["doc-17", "doc-21"],
  "confidence": 0.82,
  "constraints": {
    "has_source": true,
    "within_scope": true,
    "tool_arguments_valid": true
  }
}
Le contract ne prouve pas que le contenu est vrai. Il rend explicites les conditions à vérifier avant publication. Le constraint solver peut alors vérifier des relations simples — valeur dans une plage, ressources disponibles, échéance respectée — tandis qu’un humain ou un autre composant examine la pertinence et l’interprétation.
Cette séparation réduit le risque de donner à un seul LLM trois responsabilités incompatibles : produire une réponse, déclarer qu’elle est correcte et décider qu’elle peut être exécutée.
Prenons une demande de réservation d’une ressource informatique. Le LLM peut proposer une durée et une machine. Le constraint solver vérifie ensuite que la ressource existe, que la durée respecte le budget et qu’aucune réservation prioritaire ne crée de conflit. Le résultat peut être :
candidate → machine = gpu-2, durée = 20 min
constraints → budget respecté, ressource disponible, deadline respectée
decision → accept avec sources et identifiant de réservation
Si une seule contrainte échoue, le système ne devrait pas modifier silencieusement la proposition. Il peut demander une autre durée, proposer une autre ressource ou s’abstenir. Cette explicitation est importante pour les tests : on peut vérifier chaque contrainte séparément et comprendre pourquoi la décision finale a changé.
La difficulté la plus intéressante apparaît lorsque deux contraintes sont incompatibles. Le système doit alors expliquer le conflit, demander quelle priorité appliquer ou transmettre la décision à une personne. La capacité à négocier les contraintes est souvent plus utile que la production d’une réponse supplémentaire.
Rendre l’abstention utile
Dire « je ne sais pas » ne suffit pas. Une abstention, ou selective prediction, est utile lorsqu’elle indique la condition manquante : source introuvable, conflit entre documents, permission absente, score de récupération trop faible ou règle métier non satisfaite. L’utilisateur peut alors fournir une précision, corriger la base de connaissances ou demander une revue humaine.
Un bon test n’évalue pas seulement la qualité des réponses acceptées. Il vérifie aussi que le système refuse correctement les questions hors périmètre et qu’il ne transforme pas une source ambiguë en certitude.
Évaluer la chaîne complète
Les métriques doivent distinguer récupération et génération : couverture des sources, exactitude des citations, taux de réponses vérifiées, appels d’outils réussis, violations de schéma, abstentions justifiées et coût par requête. Une amélioration du texte final qui augmente les erreurs de provenance n’est pas une amélioration du système.
Pistes à découvrir
Une expérimentation simple peut comparer trois architectures : LLM seul, RAG avec citation, puis RAG complété par un solveur et une règle d’abstention. Il faut évaluer séparément la pertinence, la fidélité aux sources, le respect des contraintes, la latence et le coût. Les cas de test doivent inclure des documents contradictoires, des informations absentes et des demandes d’outil hors périmètre.
Une piste plus ambitieuse consiste à générer un evidence certificate, ou certificat de preuve : sources consultées, contraintes satisfaites, transformations appliquées et raison d’une éventuelle abstention. Ce certificat pourrait être vérifié indépendamment du LLM. Reste une question ouverte : quelle quantité de preuve améliore réellement la confiance de l’utilisateur sans rendre le système illisible ou trop lent ?
Une règle de conception
Commencez par les contraintes qui doivent toujours être satisfaites, puis choisissez le modèle capable d’apporter de la souplesse autour de ce noyau. La génération devient alors un composant puissant d’un système gouverné, plutôt qu’un arbitre unique de la vérité.
Sources et prolongements